13 octobre 2026

Prompt Injection : quand un AI Agent devient une surface d’attaque

13 octobre 2026

Prompt Injection : quand un AI Agent devient une surface d’attaque

Un LLM connecté change le niveau de risque

Un LLM isolé peut produire une réponse incorrecte ou être manipulé. Mais lorsqu’il devient le moteur d’un AI Agent connecté au système d’information, les conséquences changent d’échelle : il peut consulter des documents, appeler une API, interroger un CRM ou un ERP, utiliser des outils et parfois exécuter des actions.
C’est là que la prompt injection cesse d’être uniquement un problème lié aux réponses du modèle. Dans une architecture agentique, une instruction malveillante peut potentiellement influencer une chaîne d’actions réelles. OWASP souligne d’ailleurs que l’impact d’une prompt injection dépend fortement du contexte métier et du niveau d’autonomie accordé au système.

Le danger peut commencer dans un simple document

Une attaque ne nécessite pas forcément qu’un attaquant dialogue directement avec l’AI Agent.
Prenons un scénario d’entreprise relativement courant. Un agent utilise un système RAG pour rechercher des informations dans des documents internes. Il est également connecté à plusieurs applications métier afin d’aider les collaborateurs à réaliser certaines tâches.
Un document apparemment légitime est ajouté à une source consultée par le RAG. À l’intérieur se trouve une instruction conçue non pas pour le collaborateur, mais pour le modèle.

Lorsque le document est récupéré et intégré au contexte, l’agent peut interpréter cette instruction comme quelque chose qu’il doit suivre.
On parle alors d’indirect prompt injection : selon le NIST, l’injection est réalisée à travers une ressource contrôlée plutôt que directement via l’entrée de l’utilisateur.

Illustration 1 : de la donnée malveillante à l’action

Document malveillant → RAG → Prompt Injection → AI Agent → Credential → API → ERP / CRM / File Server → Exfiltration ou Action
Le point critique de cette chaîne n’est pas uniquement la capacité de l’attaquant à influencer le modèle. C’est ce que l’agent est autorisé à faire après cette influence.

Un LLM connecté n’a plus le même profil de risque

Dans un chatbot isolé, une prompt injection peut notamment modifier une réponse, contourner certaines instructions ou provoquer la divulgation d’informations accessibles au modèle. Avec un AI Agent connecté, le modèle peut devenir une interface vers des capacités opérationnelles. Microsoft résume ce changement de manière concrète : les agents équipés d’outils ne se limitent plus à générer du texte. Ils peuvent lire des fichiers, rechercher dans des bases connectées, lancer des scripts ou réaliser d’autres opérations sur le réseau. Une prompt injection susceptible de contrôler les paramètres transmis à ces outils peut alors conduire l’agent à effectuer des actions qui dépassent son usage prévu.
La question pour le CISO ou le SOC Manager n’est donc plus seulement : « Le modèle peut-il être manipulé ? » Elle devient : « Que peut atteindre un attaquant si le modèle est manipulé ? »

Le RAG n’élimine pas la Prompt Injection

Le RAG permet d’enrichir le contexte d’un modèle avec des informations provenant de sources spécifiques. Mais cette architecture crée également une relation de confiance entre le modèle et les données qu’il récupère.
Or une donnée récupérée n’est pas nécessairement une donnée fiable.
Un document, un ticket, une page web, un e-mail ou une autre ressource peut contenir des instructions hostiles. Si elles sont récupérées avec le contenu métier et intégrées au contexte du modèle, la frontière entre donnée à analyser et instruction à suivre devient un enjeu de sécurité.
OWASP indique explicitement que le RAG et le fine-tuning ne permettent pas, à eux seuls, d’éliminer les vulnérabilités de prompt injection.

Pour une architecture RAG d’entreprise, sécuriser uniquement le prompt système n’est donc pas suffisant. Il faut également considérer les sources documentaires comme des entrées potentiellement non fiables.

Lorem ipsum dolor sit amet, consectetur adipiscing elit. Ut elit tellus, luctus nec ullamcorper mattis, pulvinar dapibus leo.

Le vrai multiplicateur de risque : les outils

Un AI Agent devient réellement intéressant pour l’entreprise lorsqu’il peut agir. Il peut par exemple rechercher une fiche dans le CRM, consulter un document, créer un ticket, envoyer un e-mail, interroger un ERP ou appeler une API. Mais chaque outil supplémentaire étend également ce qu’une manipulation réussie pourrait permettre d’atteindre. Le raisonnement peut être résumé ainsi : Prompt Injection × Permissions × Tools × Autonomy = Impact potentiel
Il ne s’agit pas d’une formule statistique, mais d’un modèle de lecture du risque. Un agent disposant de peu d’accès et incapable d’exécuter des actions présente un périmètre d’impact limité. Le même type d’injection appliqué à un agent disposant de credentials puissants, de plusieurs outils et d’une forte autonomie peut avoir des conséquences très différentes.
OWASP décrit ce problème sous le concept d’Excessive Agency : des actions dommageables peuvent être réalisées lorsqu’un système LLM dispose de fonctionnalités, permissions ou autonomie excessives face à des sorties manipulées ou inattendues.

Les credentials transforment l’agent en point de passage vers le SI

Pour appeler les systèmes de l’entreprise, un AI Agent doit généralement disposer d’une identité ou utiliser des mécanismes d’autorisation : tokens OAuth, API keys, comptes techniques, managed identities ou autres credentials. Une prompt injection ne donne pas nécessairement directement ces credentials à l’attaquant. Le danger peut être plus subtil : elle peut pousser l’agent à utiliser ses propres autorisations d’une manière non prévue. Imaginons un agent capable de consulter le CRM et d’envoyer des e-mails. Si une instruction malveillante parvient à influencer son workflow, la combinaison de ces deux capacités peut devenir plus sensible que chacune prise séparément.
Microsoft a documenté en 2026 un scénario dans lequel une instruction malveillante placée dans un document partagé pouvait amener un agent disposant des accès nécessaires à rechercher un fichier sensible puis à tenter d’en exfiltrer le contenu par e-mail.

De la Prompt Injection à l’action métier

Pour un SOC, il est utile d’observer la prompt injection non comme un événement isolé, mais comme le début potentiel d’une chaîne.

Illustration 2 : AI Agent Attack Chain
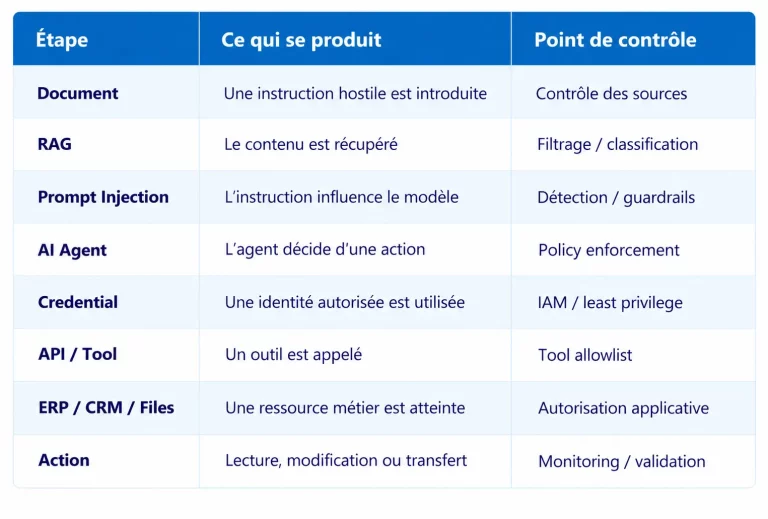
Illustration 2 _ AI Agent Attack Chain (2)
L’intérêt de cette représentation est de montrer qu’une défense efficace ne peut pas reposer sur un contrôle unique.
Même si une instruction hostile atteint le modèle, les couches suivantes doivent encore pouvoir empêcher qu’elle se transforme en action dangereuse.

Une Prompt Injection ne devrait jamais devenir une autorisation

L’une des erreurs d’architecture consiste à laisser le modèle décider à la fois ce qu’il souhaite faire et ce qu’il est autorisé à faire. Ces deux fonctions doivent rester séparées. Un agent peut décider qu’une action nécessite l’accès au CRM. Mais l’autorisation effective doit être contrôlée par une couche indépendante capable de vérifier son identité, ses permissions, l’outil demandé, la ressource ciblée et le contexte de l’action.
AI Agent → demande une action → Policy vérifie → IAM autorise → Tool exécute → SOC observe
Microsoft recommande notamment des rôles liés aux tâches, des scopes explicites, des allowlists d’outils, des privilèges temporaires et une nouvelle vérification de l’autorisation dans les systèmes en aval.

Le SOC doit surveiller l’action, pas seulement le prompt

Détecter une instruction suspecte reste utile, mais une approche centrée uniquement sur le texte du prompt laisse une partie importante du risque hors du champ de surveillance. Un SOC doit également observer ce que fait l’agent après avoir traité l’information. Un agent qui consulte soudainement une nouvelle ressource, appelle une API inhabituelle, augmente fortement son volume de requêtes, utilise un outil jamais sollicité auparavant ou tente d’envoyer des données vers une destination externe peut présenter un comportement nécessitant une investigation. Microsoft Defender analyse désormais notamment la télémétrie des agents, l’utilisation des outils et les patterns d’exécution afin de détecter des comportements comme l’indirect prompt injection, la propagation de contenu malveillant ou les fuites de secrets et de credentials. our le SOC, la visibilité doit donc suivre toute la chaîne : Prompt → Agent → Identity → Tool → API → Resource → Action

Réduire l’impact plutôt que chercher une protection parfaite

Chercher à identifier toutes les variantes possibles de prompt injection n’est pas une stratégie suffisante. Les contenus non fiables peuvent provenir de multiples sources et les techniques d’attaque évoluent. Le NIST souligne d’ailleurs, à partir de travaux de red teaming publiés en 2026, que les agents travaillant sur des e-mails, sites web, dépôts de code et autres sources externes sont exposés au risque d’agent hijacking par indirect prompt injection. L’architecture doit donc partir d’une autre hypothèse : une instruction malveillante peut finir par atteindre l’agent. À partir de là, l’objectif consiste à empêcher cette instruction de disposer d’un chemin libre jusqu’aux ressources critiques.
Cela implique de limiter les permissions de l’agent, contrôler ses outils, isoler les fonctions sensibles, restreindre les credentials, valider les actions à fort impact, surveiller son comportement et conserver une auditabilité de bout en bout.

De la Prompt Injection à l’action : où placer les contrôles ?
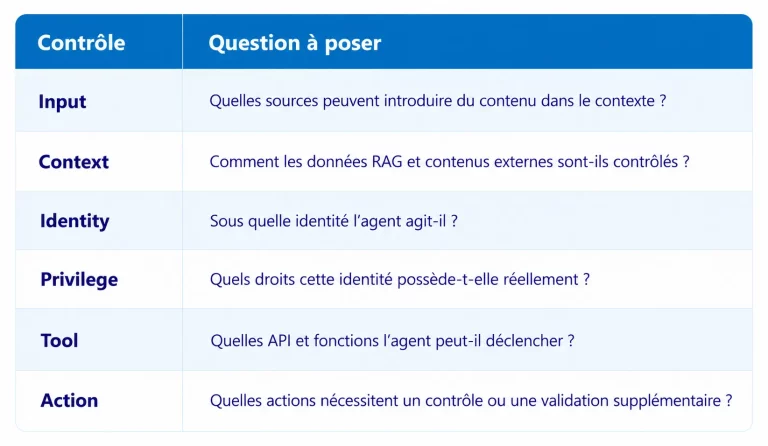
Pour analyser cette surface d’attaque, une entreprise peut examiner six frontières successives :

Illustration 3 : Prompt-to-Action Security Model

Input → Context → Identity → Privilege → Tool → Action
Ce framework éditorial permet surtout de déplacer l’analyse du prompt seul vers l’ensemble du chemin d’exécution. Une organisation peut ainsi identifier l’endroit où une manipulation du modèle pourrait réellement franchir une frontière de confiance.

Pour une entreprise tunisienne, le sujet reste architectural

Pour une entreprise tunisienne, les mécanismes techniques de la prompt injection ne sont pas différents. Le véritable enjeu réside dans l’architecture à laquelle l’AI Agent est connecté.
Cette analyse devient particulièrement importante lorsqu’un agent intervient dans des environnements bancaires, assurantiels, industriels, télécoms ou publics, ou lorsqu’il manipule des données sensibles et accède à des systèmes critiques.
Il faut notamment identifier où le modèle est exécuté, quelles données alimentent le RAG, quelles API sont accessibles, quelles identités sont utilisées, quels systèmes peuvent être modifiés et quelles informations peuvent sortir de l’environnement.

Le choix d’une architecture locale, cloud, privée ou hybride ne supprime donc pas automatiquement le risque de prompt injection. Ce sont les frontières de confiance, les permissions et les capacités d’action qui déterminent principalement l’impact potentiel.

Ce que les CISO et SOC Managers doivent vérifier dès maintenant

Avant d’étendre l’utilisation d’AI Agents connectés au SI, l’analyse devrait commencer par un scénario simple : supposer qu’une prompt injection réussit et observer jusqu’où l’agent pourrait aller. Testez les sources RAG avec du contenu non fiable, cartographiez les outils accessibles à chaque agent, vérifiez les credentials réellement utilisés, réduisez les permissions trop larges, imposez une validation humaine pour les actions critiques et assurez-vous que le SOC peut reconstruire chaque appel d’outil et chaque action. Le test décisif n’est donc pas seulement : « Notre agent détecte-t-il la prompt injection ? » mais : « Si la prompt injection fonctionne, quelles actions l’attaquant peut-il réellement provoquer ? » C’est cette seconde question qui permet d’évaluer la véritable surface d’attaque d’un AI Agent.

La Prompt Injection n’est que le début de la chaîne

La prompt injection devient beaucoup plus critique lorsque l’IA n’est plus uniquement chargée de répondre, mais qu’elle possède une identité, des credentials, des permissions et des outils lui permettant d’agir. Le modèle n’est alors qu’un maillon de la chaîne. La sécurité doit couvrir le chemin complet entre l’information reçue et l’action exécutée, avec des contrôles indépendants capables de limiter les conséquences même lorsque le modèle est manipulé. Pour un CISO ou un SOC Manager, l’objectif n’est donc pas de considérer chaque AI Agent comme intrinsèquement dangereux. Il est de savoir précisément jusqu’où cet agent peut aller si son contexte, son raisonnement ou ses outils sont compromis.

Votre AI Agent est-il réellement isolé ?

Analysez les connexions entre vos AI Agents, leurs sources RAG, credentials, API, outils et systèmes métier afin d’identifier les chemins qu’une prompt injection pourrait exploiter.

FAQ

Prompt Injection et AI Agents

1. Une Prompt Injection peut-elle provenir d’un document ?

Oui. Une indirect prompt injection peut être intégrée dans une ressource externe telle qu’un document ou une page web. Si cette ressource est ensuite traitée par le modèle, son contenu peut influencer son comportement.

2. Un système RAG protège-t-il contre la Prompt Injection ?

Non, pas à lui seul. Le RAG améliore l’accès à des informations contextuelles, mais les sources récupérées peuvent elles-mêmes contenir des instructions malveillantes. OWASP indique que le RAG ne supprime pas intrinsèquement cette vulnérabilité.

3. Pourquoi la Prompt Injection est-elle plus critique avec un AI Agent ?

Parce qu’un agent peut disposer d’outils et de permissions lui permettant d'agir sur des systèmes connectés. Une manipulation du modèle peut alors potentiellement influencer une action et pas uniquement une réponse textuelle.

4. Le least privilege peut-il limiter l’impact d’une Prompt Injection ?

Oui. Il ne bloque pas nécessairement l’injection elle-même, mais il réduit ce que l’agent peut faire si son comportement est manipulé. Les permissions, scopes et outils doivent être limités à sa mission.

5. Faut-il valider humainement toutes les actions d’un AI Agent ?

Pas nécessairement. Les validations peuvent être concentrées sur les actions à fort impact : suppression, transfert de données sensibles, changement de permissions ou opérations critiques. Microsoft recommande notamment une approbation humaine pour les actions à fort impact.

6. Comment tester l’exposition d’un AI Agent à la Prompt Injection ?

L’évaluation doit tester non seulement les prompts, mais également les contenus externes, les sources RAG, les outils, les permissions et les chemins d’exécution. Les exercices de red teaming permettent de vérifier jusqu’où une instruction hostile pourrait réellement conduire l’agent.

Cybersecurity, Cloud and AI

Lancez votre assessment Cloud et structurez votre transformation

Des informations
qui pourraient vous intéresser

IA d’entreprise : où vos données sont-elles réellement exposées

20 octobre 2026

AI Agent Security Framework : les 25 contrôles avant la mise en production

14 octobre 2026

FinOps : maîtriser les dépenses cloud de votre organisation

9 octobre 2026