
L’AI Data Security ne s’arrête plus à la base de données
Lorsqu’une entreprise connecte l’IA à son système d’information, ses données ne circulent plus uniquement entre une application et une base de données. Elles peuvent désormais traverser plusieurs composants : prompts, modèles, embeddings, bases vectorielles, systèmes RAG, agents, outils métiers, logs et plateformes de monitoring.
Le problème n’est donc plus seulement de savoir où les données sont stockées, mais de comprendre où elles sont copiées, transformées, conservées et potentiellement exposées.
Microsoft souligne justement qu’en environnement enterprise, les risques de fuite proviennent désormais souvent des couches de contexte et de retrieval : historiques de conversation, contenus RAG, embeddings, sorties d’outils, mémoire d’agents ou traces d’exécution.
Une donnée peut traverser bien plus de systèmes qu’on ne l’imagine
Enterprise Data → Prompt → LLM → Embedding → Vector DB → RAG → Agent → Logs → Monitoring
À chacune de ces étapes, une nouvelle copie, représentation ou trace de la donnée peut être créée.

L’AI Data Security doit donc protéger le parcours complet de l’information et pas uniquement sa source originale.
Illustration 1 : Enterprise AI Data Exposure Map
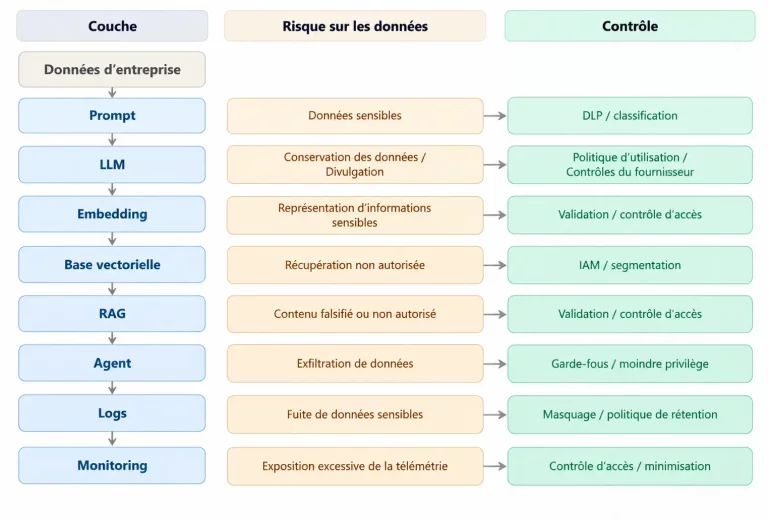
Le prompt devient lui-même une donnée sensible
Dans les environnements traditionnels, les collaborateurs savent généralement qu’un fichier client ou qu’une base financière contient des informations sensibles.
Le risque est moins évident avec un prompt.
Un utilisateur peut copier un contrat, un extrait de code, des informations commerciales ou des données personnelles dans une interface IA sans considérer cette interaction comme un transfert de données.
Pourtant, dès que l’information entre dans le prompt, plusieurs questions apparaissent : où est-elle traitée ? Est-elle conservée ? Apparaît-elle dans les logs ? Peut-elle être utilisée par une autre fonctionnalité ? Quel fournisseur intervient dans le traitement ?
Pour les entreprises, une politique d’AI Data Security doit donc considérer les prompts comme un véritable canal de circulation des données et leur appliquer classification, DLP et règles d’usage adaptées.
Le RAG peut respecter les droits d’accès… ou les contourner
Le RAG permet à un assistant d’exploiter les connaissances internes sans intégrer l’ensemble des documents directement dans le modèle.
Mais un problème apparaît lorsque les permissions appliquées au système documentaire ne sont pas correctement reproduites au niveau du retrieval.
Imaginons une base documentaire contenant des informations accessibles à plusieurs départements. Si les documents sont indexés dans une même base vectorielle sans conserver correctement les ACL, un utilisateur pourrait recevoir un extrait provenant d’un document auquel il n’aurait normalement pas accès.
OWASP identifie précisément le cross-context information leakage et les contrôles d’accès inadéquats comme des risques liés aux systèmes de vectors et embeddings. L’organisation recommande notamment des bases vectorielles tenant compte des permissions pour limiter la récupération aux informations effectivement autorisées.
Les embeddings ne sont pas nécessairement anonymes
Transformer un document en vecteurs ne signifie pas que son contenu cesse d’être sensible.
Les embeddings sont des représentations numériques conçues pour conserver des propriétés sémantiques permettant notamment la recherche par similarité. Selon les architectures et les attaques considérées, ils peuvent eux-mêmes présenter des risques de confidentialité.
OWASP inclut notamment les attaques d’embedding inversion, les accès non autorisés et les fuites entre contextes parmi les vulnérabilités des architectures utilisant embeddings et vector databases.
Une base vectorielle contenant des représentations issues de contrats, dossiers clients ou documents stratégiques doit donc être considérée comme une composante sensible du système d’information, avec authentification, segmentation, chiffrement et politiques de rétention adaptées.
Le risque ne concerne pas uniquement la confidentialité
L’agent ajoute une nouvelle frontière de sortie des données
La donnée peut donc quitter l’environnement initial non pas parce qu’un utilisateur l’a téléchargée, mais parce que l’agent a décidé d’utiliser un outil. Ce point change profondément le modèle de sécurité. Les contrôles doivent porter sur la donnée elle-même, mais également sur les outils auxquels l’agent peut accéder, les destinations autorisées et les permissions utilisées lors de chaque opération.
Les logs peuvent devenir une copie oubliée des données sensibles
Le compromis consiste donc à conserver suffisamment de traces pour sécuriser le système sans recréer involontairement un second référentiel de données sensibles dans les plateformes de monitoring.
La mémoire des AI Agents crée une nouvelle problématique de rétention
AI Data Security : cartographier les données avant de sécuriser les modèles
Pour chaque application IA, l’entreprise devrait pouvoir répondre à plusieurs questions fondamentales :

Cette démarche permet de déplacer l’AI Data Security d’une logique centrée sur le modèle vers une logique centrée sur le cycle de vie réel de la donnée.
Quelles données doivent être bloquées avant même d’atteindre l’IA ?
Pour une entreprise tunisienne, la localisation n’est qu’une partie du problème
Une donnée peut rester physiquement en Tunisie tout en étant accessible à trop d’utilisateurs, copiée dans des logs non protégés ou transmise à une API externe par un agent. Inversement, certaines architectures hybrides peuvent appliquer des mécanismes stricts de classification et empêcher les données les plus sensibles de quitter un périmètre contrôlé. Pour les banques, assurances, télécoms, industries ou organismes publics, l’analyse doit donc combiner localisation, classification, accès, flux, fournisseurs et cycle de vie. Toute exigence réglementaire spécifique doit être vérifiée selon les textes et autorités compétentes plutôt que présumée.
Ce que les CISO, DPO et CIO doivent vérifier maintenant
La sécurité IA converge avec la gouvernance des données
Pour 2027, on peut raisonnablement anticiper une intégration plus forte entre sécurité IA, DLP, IAM, gouvernance des données et monitoring. Il s’agit d’une projection, mais elle correspond à l’évolution actuelle des architectures enterprise.
La donnée devient la véritable surface de contrôle de l’IA
Découvrez où vos données peuvent être exposées par l’IA
FAQ
AI Data Security
1. Les données envoyées dans un prompt doivent-elles être considérées comme des données traitées par le SI ?
Oui. Dès qu’une information est transmise à un service IA, elle entre dans une nouvelle chaîne de traitement. L’entreprise doit donc connaître les conditions de traitement, de conservation, de journalisation et d’accès applicables au service utilisé.
2. Une base vectorielle peut-elle contenir des données sensibles ?
Oui. Les embeddings sont des représentations dérivées des données sources et ne doivent pas être considérés automatiquement comme anonymes. Les bases vectorielles nécessitent donc des contrôles d’accès, une segmentation et des politiques de protection adaptées.
3. Comment éviter qu’un RAG expose un document à un utilisateur non autorisé ?
4. Pourquoi les logs IA représentent-ils un risque de fuite ?
5. La localisation des données suffit-elle à garantir l’AI Data Security ?
6. Comment commencer un audit AI Data Security ?
Commencez par cartographier le parcours d’une donnée sensible réelle : source, prompt, modèle, embeddings, RAG, agents, outils et logs. Identifiez ensuite chaque copie, transformation, changement de frontière de confiance et mécanisme d’accès.
mi